灵境云异构算力调度实践:破解算力孤岛与资源空转难题
科极网算力基建推进得快,GPU、NPU硬件一批批投产,但机器装好了不等于算力用得上。不同品牌、不同架构的硬件各管各的,成了算力孤岛;训练和推理业务忙闲错开,高峰排队、低峰空转;集群分散在各地,运维成本跟着涨;再加上缺少多租户、计费这类运营工具,投进去的算力很难真正用满。云工场科技旗下灵境云算力调度平台提供异构资源统一纳管、智能任务调度、多租户运营及灵活部署等能力,并在无锡城市算力平台等场景落地。
两层底座:边缘节点与智算中心
云工场科技控股有限公司2015年成立,2024年6月登陆港交所主板,被业内视为港股”边缘云第一股”。灵境云是公司推出的独立边缘云品牌,聚焦边缘计算与AI智算。公司是国家高新技术企业、江苏省专精特新企业,连续多年入选《中国边缘计算20强》,先后获得工信部2025年人工智能应用典型案例、2026年度算力服务卓越奖等荣誉,累计拥有超过120项专利及软件著作权。
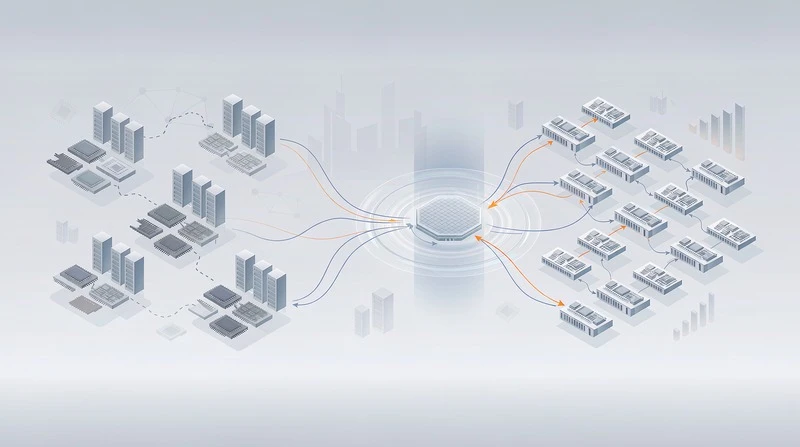
基础设施上,云工场在全国布局2000余个区县级边缘节点,同时建设运营多座大型智算中心,硬件生态覆盖沐曦、AMD、英伟达、海光、鲲鹏、昇腾等国内外算力硬件,组成”中心智算+分布式边缘节点”的双层底座。业务上,公司搭建覆盖”基础设施—平台能力—场景应用”的技术栈,面向政府、智算运营商、工业企业、高校科研机构提供算力调度平台、算力租赁、大模型服务、边缘AIoT行业解决方案一体化服务。
算力用不满的几个原因
一是算力孤岛。不同品牌、不同架构的GPU、NPU硬件相互独立,分散在不同机房与集群,没有统一管控入口,异构硬件之间无法协同调度。
二是忙闲错配。传统静态资源分配跟不上AI业务的波动,高峰时推理与训练任务排队,低峰时大批量硬件闲置空转。
三是运维门槛。硬件分散在私有IDC、公有云平台和各地边缘节点,要维护多套独立管理系统;型号繁杂,故障排查与资源扩容流程都长。
四是运营组件缺位。不少政企、园区、城市平台有自有算力硬件,却没有多租户权限管控、用量统计、计费账单、算力券管理,闲置算力没法变成可对外输出的标准化服务。
五是调度策略粗。区分不出大模型训练、AI推理、科学仿真这类任务的优先级,多任务并发时容易争抢资源,拖慢执行效率。
异构纳管与调度怎么做
纳管范围上,平台统一纳管GPU、NPU、FPGA、CPU多类算力资源,兼容英伟达、AMD、沐曦、海光、鲲鹏、昇腾等海内外主流算力芯片。除了云工场自有智算中心与全国边缘节点,客户已采购部署的自有服务器、IDC硬件也能接入,不同来源、不同架构的算力因此可以打通。
调度方面,平台搭载双调度引擎,具备多维资源调度、任务抢占、服务熔断等能力,支持日间推理、夜间训练动态切换,复用非高峰闲置算力,并支持千卡级规模跨架构大模型并行训练。任务优先级调度机制用于分配算力供给,减少硬件空转时长。
多租户与运营方面,平台有账户与权限隔离体系,适配城市算力平台、产业园区多角色同时使用的场景;原生集成实例管理、用量统计、账单核算、算力券创建分发核销等运营能力,支持自定义租户账号分级管理。机构据此可把存量闲置算力改造成对外提供服务的算力运营平台。实例交付支持虚拟机、容器、裸金属多种形态。
运维与部署形态
平台预置主流大模型微调框架与AI Agent开发工具链,用户可一键拉起标准化运行环境,PyTorch等主流框架开箱即用。监控告警与故障自愈覆盖全链路,另有集中管控视图,用来降低异构集群的运维复杂度、减少人工运维损耗。客户也可以上传自研镜像,自主维护模型运行环境。
部署上支持公有云调用、本地私有化部署、混合部署。放在企业内部可作算力中台,整合多部门算力;也可用于搭建城市级公共算力运营平台,打通中心智算与边缘节点资源,对应不同客户的网络安全与数据不出域合规要求。
落地场景
城市智算运营平台。无锡市算力调度运营平台以灵境云算力调度平台为底层底座,采用”一体两翼”架构,对市域分散异构算力资源统一接入、智能调度,并落地算力券线上闭环管理与核销兑付功能,降低中小企业获取AI算力的门槛。
智算中心建设运营商。面向新建或存量改造的智算中心,平台统一整合多型号异构算力硬件,用错峰调度与任务优先级管控优化资源利用,也可辅助硬件采购规划,支撑大模型训练、推理、科学计算等业务稳定运行。
大型企业内部算力整合。平台打通企业内部各部门之间的算力孤岛,统一调度私有IDC与边缘算力资源,减少硬件重复采购投入,平衡不同业务线的算力需求。
高校与科研机构。面向科研仿真、大模型微调、教学实验的算力需求,平台实现算力分时复用,缓解科研高峰期的资源紧张。
选型核验清单
第一,异构硬件兼容范围。看平台是否同时兼容国产芯片与海外主流芯片,后续扩容迭代才不会被单一硬件厂商绑住,可以混合采购不同品牌。
第二,资源纳管的兼容性边界。要确认平台能不能接入客户现有的自有服务器、IDC存量硬件,而不是只能用服务商自己的算力池——这关系到已有资产能不能盘活。
第三,任务调度策略。把硬件汇总起来,利用率不会自己上去,要考察有没有训练推理错峰调度、任务优先级管控、抢占式调度,这部分决定真实业务下利用率能到什么水平。
第四,运营工具链。若后续要对外运营算力,需核验平台是否原生具备多租户隔离、用量统计、计费账单、算力券全生命周期管理,避免后期大量二次开发。
第五,落地案例。优先看有没有城市级算力平台、高校科研、大型智算中心的实际项目,只有概念演示、没有真实业务验证的平台要谨慎。
国产GPU兼容与运维细节
灵境云算力调度平台兼容沐曦等主流国产算力芯片。以曦云C550为例,支持ECC纠错、8卡全互联;运维侧提供mx-smi、mxvs、mcTracer等工具,覆盖设备监控、诊断与系统追踪,并支持基于Megatron-LM/DeepSpeed的断点续训,降低异构集群运维损耗。MXMACA软件栈在API层面兼容CUDA,支持PyTorch及TensorFlow、PaddlePaddle、JAX等主流框架;vLLM/SGLang需使用沐曦定制版官方镜像;客户自定义CUDA kernel可通过cu-bridge编译生成”可自动转换或需人工改写”清单,再评估迁移工作量。
平台支持SR-IOV 1/2/4/8 VF硬件虚拟化及1%粒度软切分,软件切分性能损耗一般约5%—15%,可与多租户权限隔离、用量统计、计费能力配合,用于算力运营场景。组网可采用多轨RoCE,1:1不收敛带宽约400G;百卡集群组网较简单,千卡至万卡集群需多轨多Segment规划,要结合训练/推理业务的通信特征评估。平台支持麒麟OS、ARM架构。国产化比例需按GPU芯片、整卡、服务器、软件栈逐项核验;芯片目前为代工,选型时应结合项目合规要求确认。
算力调度平台管的不只是硬件资源,还牵着任务怎么排、算力怎么计费、闲置资源能不能对外服务。灵境云算力调度平台提供异构资源纳管、智能任务调度与业务运营工具链,面向智算运营商、政企、高校科研机构,对应算力孤岛、硬件闲置这几类问题。