智象未来发布视频模型HD-V1,采用物理规律导向生成逻辑
来源:互联网9月15日,智象未来(HiDream.ai)正式发布原生全模态视频生成模型HiDream-O1-Video-1.0(简称HD-V1)。该模型支持文本、图片、视频等多种模态输入,可一键生成5至20秒1080p高保真视频。
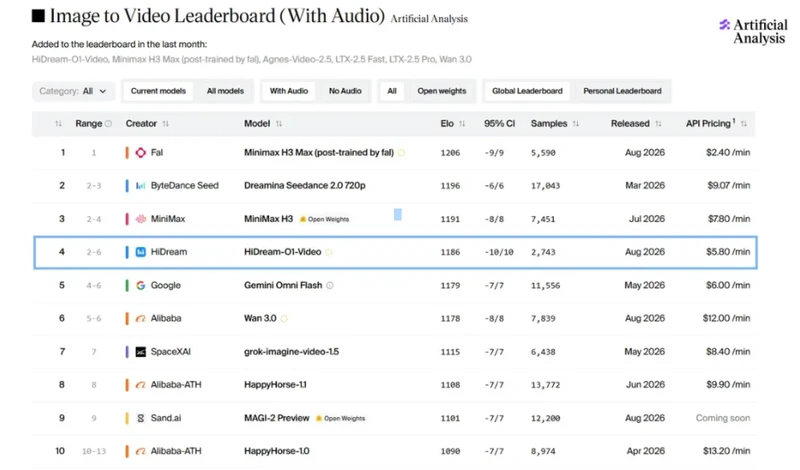
双榜排名进入全球第一梯队
在全球AI评测平台Artificial Analysis的Image to Video Leaderboard(With Audio)榜单中,HD-V1位列全球第四。在Arena.ai的Image-to-Video盲测榜单中,HD-V1排名全球第八。这两项榜单均为第三方机构评估AI视频模型综合实力的重要参考。
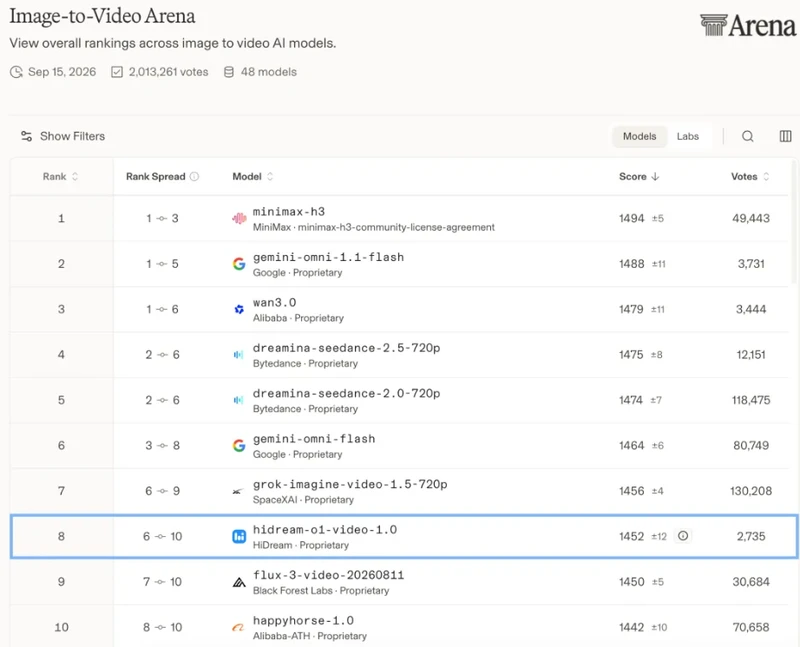
物理规律纳入生成逻辑
HD-V1前置多模态意图理解模块,可对视频内容进行结构化规划,覆盖镜头时长、场景地点、画面内容、角色动作与表情、运镜焦段、台词与背景声等字段。模型将物理规律引入生成过程,使物体在重力、碰撞、惯性、光影衰减及空间连续性等方面的表现更接近真实物理状态。
在音画生成方面,HD-V1采用文本、视频、音频联合建模,实现音画原生一体化生成。镜头切换时,环境声与配乐随之过渡;人物开口时,口型、气口与情绪保持同频。
时长与内容情境绑定
HD-V1将时长选择与内容情境绑定。模型根据事件展开逻辑、动作完成周期及叙事推进节奏自行规划生成时长,而非简单填充固定时间窗口。
模型矩阵完成布局
随着HD-V1发布,智象未来已完成图像生成模型HiDream-O1-Image、交互式世界模型HiDream-O1-World、具身世界模型HiDream-O1-Embodied及视频模型HD-V1的矩阵布局。智象创始人梅涛博士表示,公司致力于构建“一个原生全模态底座、四大模型同源演进”的模型矩阵。
同日,智象未来宣布完成C+轮融资,投资方为新微资本、交子资本、工银资本。