云知声发布U2-Flash:总参数与激活参数分离,模型参与自身训练
来源:互联网近日,云知声对外发布了一款名为U2-Flash的新模型。该模型在架构设计上采用了总参数与激活参数分离的方式,其总参数量与单次推理实际激活的参数量之间存在明显差异。这一设计使得模型在保持较大参数规模的同时,能够在推理阶段仅调用其中一部分参数完成计算。
从已公布的信息来看,U2-Flash的总参数量与激活参数量处于不同的量级。这种设计通常旨在降低推理时的计算开销,同时保留大参数模型所具备的表达能力。云知声此次发布并未将重点放在单纯扩大参数总量上,而是通过分离总参数与激活参数,尝试在模型能力与运行效率之间取得平衡。
模型参与自身训练
U2-Flash的一个显著特点是模型参与了自身的训练过程。这意味着在训练阶段,模型并非完全依赖外部固定的训练信号或人工标注数据,而是以某种方式介入了自身参数的更新与优化。这一机制与常见的监督训练或纯人工反馈训练流程有所不同,体现了云知声在训练方法上的探索。
在传统的监督训练流程中,模型参数的更新主要依据外部给定的输入输出对或人工反馈信号,模型本身处于被动的参数调整状态。而U2-Flash所采用的训练方式,将模型自身置于训练环节的参与位置,使其能够对参数更新过程产生直接影响。这一做法改变了训练信号的来源结构,使模型不再仅仅作为被优化的对象,而是在优化过程中承担了更主动的角色。云知声将这一训练机制作为U2-Flash对外披露的核心信息之一,显示出其在模型训练方法论上的差异化思路。
参数规模的分离设计
U2-Flash在参数规模上的处理方式,体现了云知声对推理效率与模型能力之间关系的重新审视。总参数量与激活参数量的分离,意味着模型在存储层面保持完整的参数集合,但在实际推理过程中并不需要全部参数同时参与计算。这种设计使得模型可以在单次推理中调用较少的参数完成前向计算,从而减少计算资源的消耗。
与此同时,未被激活的参数仍然保留在模型整体结构之中,为模型提供更丰富的潜在表达能力。云知声此次发布并未将重点放在单纯扩大参数总量上,而是通过分离总参数与激活参数,尝试在模型能力与运行效率之间取得平衡。这一策略与单纯追求参数规模扩张的路径形成对比,反映出云知声在模型设计上对实际部署条件的考量。
发布信息的范围
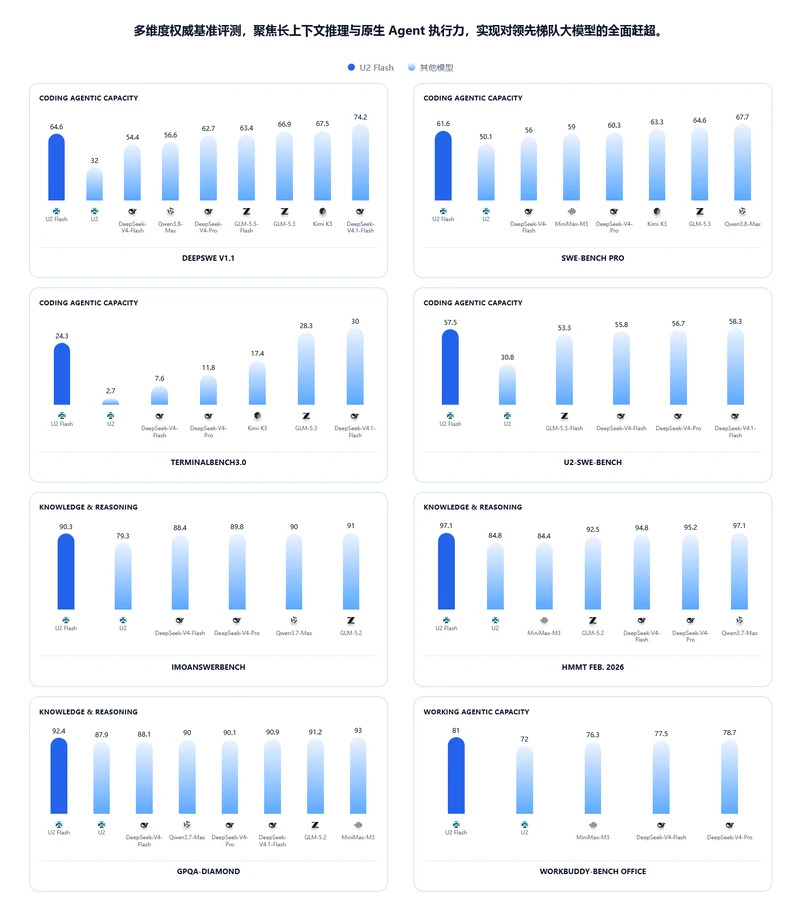
云知声此次发布的U2-Flash,将模型训练方式与参数调用策略作为核心信息对外披露。关于该模型的具体应用场景,云知声在本次发布中未作进一步展开,但公布了训练数据规模及实际性能表现数据。
从发布内容的结构来看,云知声将信息重点集中在模型架构层面的两个关键设计上:一是总参数与激活参数的分离,二是模型参与自身训练。这两项内容构成了U2-Flash区别于其他模型的主要技术特征。云知声在发布中对这两项特征的描述,均围绕模型自身的结构与训练机制展开,并涉及了外部评测数据与与其他模型的对比结果。此次发布既包含技术路线的说明,也展示了详细的性能指标数据。